2026 年 9 月 9 日
由于现在时间太紧,无法慢慢做项目了,只能先尽量从网上找到现成的项目,大体理解其中的技术细节后,再融会贯通成自己的东西。如果还有空余时间,再考虑复现,或者自己从头开始搭建。
目前主流的 AGENTS 项目方向
我向 ChatGPT 提供了几十份来自小红书的 AGENTS 简历,让它分析目前主流的 AGENTS 项目内容,大致得到以下分布:
| 方向 | 出现情况 | 典型场景 |
|---|---|---|
| RAG、知识库、文档检索 | 约 19 份 | 企业知识库、校园、科研、医疗、水务 |
| 垂直业务 Agent | 10 份以上 | 差旅、客服、金融投研、资产处置、安全漏洞 |
| Coding Agent / Harness | 约 7 份 | CLI、仓库修改、测试、MCP 配置 |
| Agent 评测 / 轨迹优化 | 约 8 份 | LLM-as-Judge、轨迹评分、回放、可观测性 |
| SFT / DPO / GRPO 等后训练 | 约 6 份 | 工具调用、客服、Coding、医疗问答 |
| 多模态 Agent | 约 3 份 | 机器人、医学图像、复杂版式文档 |
面向科研实验的统计分析 Agent
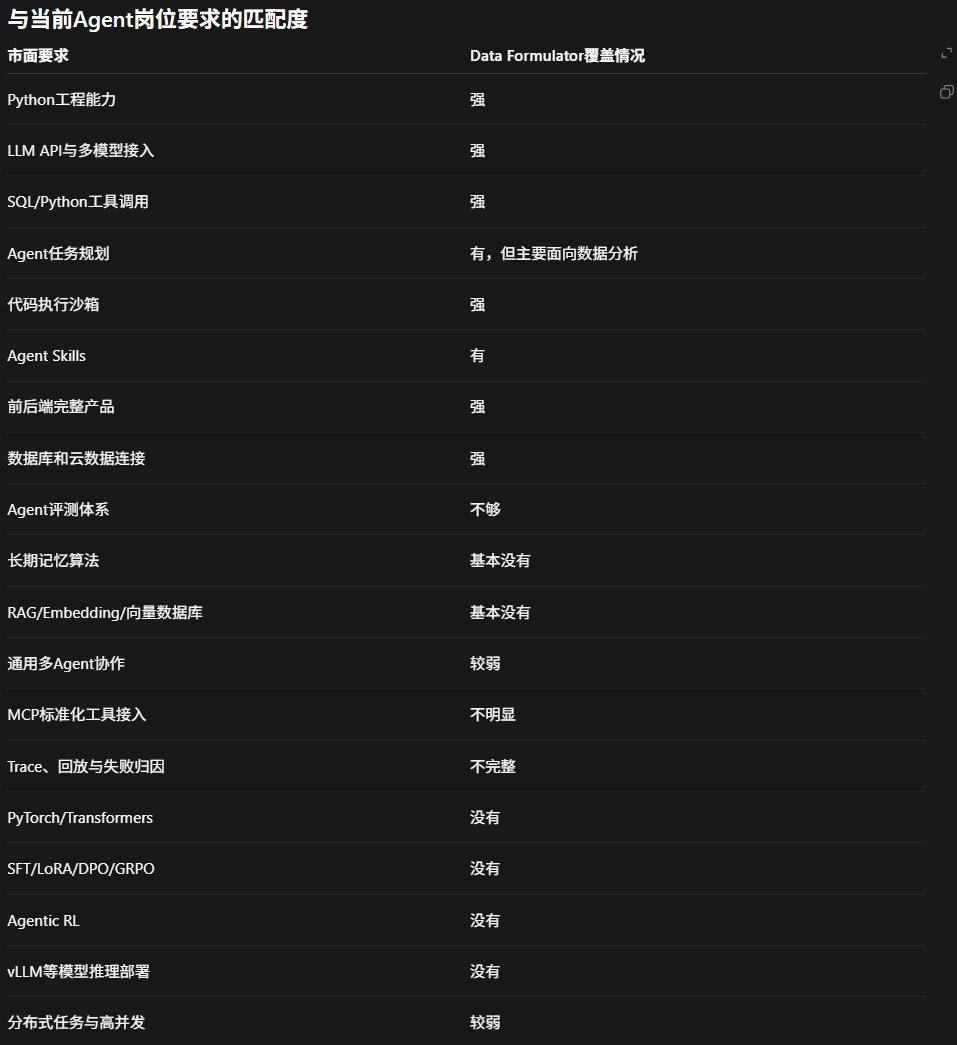
GPT 5.6 sol 推荐我根据 Data Formulator 进行二次开发。我估计,这可能是因为我有本科数学专业和数学建模经历,因此它建议我把方向改成:
面向科研实验和 A/B 测试的统计分析 Agent,自动选择统计方法、检查假设条件,并验证生成结论。
重点可以增加三个模块:
1. Statistical Planner
根据变量类型、样本量和研究问题,选择 t 检验、卡方检验、回归、非参数检验等方法。
2. Assumption Verifier
检查正态性、方差齐性、共线性、样本独立性和数据泄漏。
3. Conclusion Auditor
检查 LLM 写出的结论是否与 p 值、置信区间、效应量一致,防止出现“显著但无实际意义”或“把相关说成因果”等问题。
可以接入的评测集
- IDA-Bench:多轮交互式数据分析任务。
- RealDataAgentBench:专门评价统计有效性、代码质量和效率。
这种数据分析方向的 AGENTS 虽然市面上做得相对少,但使用的技术栈与目前市面上的主流技术相差不大,仍然有机会把已有方法迁移到更具体的科研场景中。
对插件机制的观察
目前官方开放的插件机制主要是数据源 Loader 插件,例如接入内部数据库、SaaS API;它并不是 LangChain / LangGraph 那种可以直接注册新 Agent、Workflow 和 Tool 的插件体系。
找工作好难,找项目好难。
一起聊聊
欢迎留下想法。评论由 GitHub Issues 托管,登录 GitHub 后即可参与。
评论框没有显示?直接在 GitHub 留言 ↗