这是一份阶段性的 Agent 学习笔记。我目前把重点放在三个层面:理解经典智能体范式、动手搭建最小可用框架,以及尽早建立评测意识。
学习计划
| 章节 | 建议优先级 | 学习方式 | 原因 | 完成 |
|---|---|---|---|---|
| 第 1 章:初识智能体 | 高 | 精读 | 建立 Agent、环境、感知、行动、目标的基本模型 | ✅ |
| 第 2 章:发展史 | 低 | 快速浏览 | 建立历史脉络即可 | ✅ |
| 第 3 章:LLM 基础 | 中 | 选择性阅读 | 理解 token、上下文、提示、Transformer 和模型局限;首轮不必推导公式 | |
| 第 4 章:经典范式 | 最高 | 精读并重写代码 | ReAct、Plan-and-Solve、Reflection 是后续基础 | ✅ |
| 第 5 章:低代码平台 | 低至中 | 选一个体验 | 了解产品形态,不必同时掌握 Coze、Dify、n8n | |
| 第 6 章:框架实践 | 中 | 横向比较,选一个 | 了解框架帮你封装了什么,不要同时深学所有框架 | |
| 第 7 章:自建 Agent 框架 | 最高 | 精读并动手实现 | 理解模型适配、消息、Agent 基类、工具注册和运行循环 | ✅ |
| 第 8 章:记忆与检索 | 最高 | 精读,做 RAG 项目 | 解决外部知识、长期记忆和事实依据问题 | |
| 第 9 章:上下文工程 | 最高 | 精读并实验 | 决定长任务稳定性、成本和信息利用率 | |
| 第 10 章:通信协议 | 高 | MCP 实做;A2A/ANP 先理解 | MCP 已很实用,多 Agent 协议可后置 | |
| 第 11 章:Agentic-RL | 后置 | 第二轮再学 | 属于模型训练方向,入门应用开发暂时用不到 | |
| 第 12 章:性能评估 | 最高 | 提前学习并建立测试集 | 没有评测的 Agent 只能算演示 | |
| 第 13 章:旅行助手 | 高 | 作为综合项目参考 | 包含数据模型、多 Agent、MCP 和前后端 | |
| 第 14 章:Deep Research | 高 | 与第 13 章二选一 | 适合练搜索、筛选、引用和报告生成 | |
| 第 15 章:赛博小镇 | 低 | 兴趣扩展 | 项目有趣,但涉及游戏和社会模拟,主线较远 | |
| 第 16 章:毕业设计 | 高 | 用自己的题目完成 | 检验能否独立设计完整系统 |
名词与接口
流式输出
模型生成回答需要时间。使用流式响应,可以在收到第一段文本时就显示,让用户边等边看;如果等完整回复,则生成期间终端不会显示回答。
如果后续还需要使用完整答案,需要同时收集并拼接各段文本:
# 处理流式响应
print("✅ 大语言模型响应成功:")
collected_content = []
for chunk in response:
    if not chunk.choices:
        continue
    content = chunk.choices[0].delta.content or ""
    print(content, end="", flush=True)
    collected_content.append(content)

full_answer = "".join(collected_content)
llm.invoke()
这里的 llm.invoke() 用来向大语言模型发送消息,等待模型生成完成,然后返回完整的回复文本。其内部调用可以写成:
response = self._client.chat.completions.create(
    model=self.model,
    messages=messages,
    # temperature、max_tokens 等参数
)
return response.choices[0].message.content
经典智能体范式
ReAct:Thought—Action—Observation 循环
ReAct 将推理与行动交织在同一循环中:推理使行动更具目的性,行动则为推理提供事实依据。
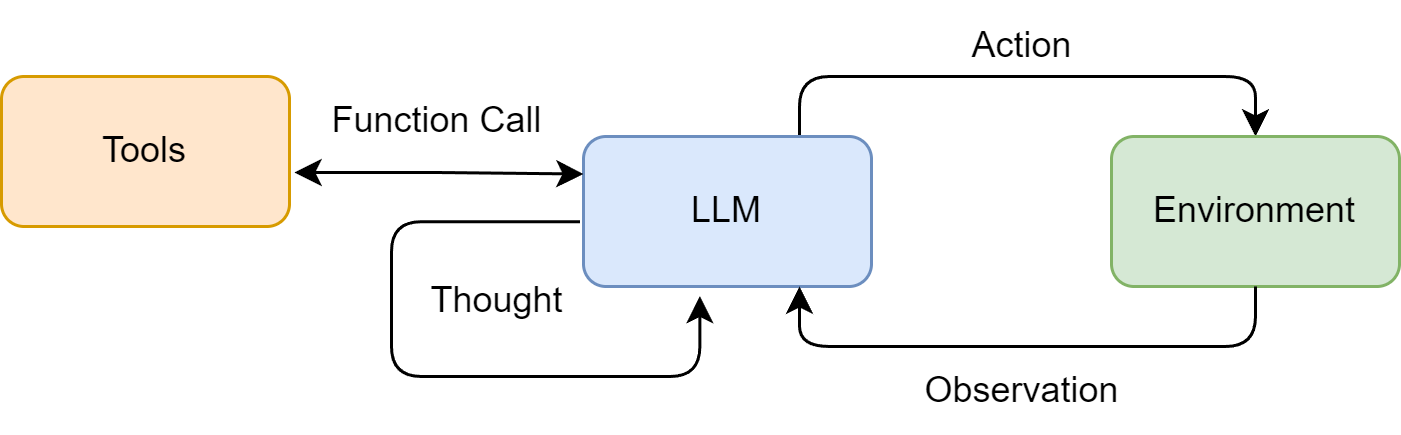
在每个时间步 $t$,大模型 $\pi$ 根据初始问题 $q$ 与之前的行动—观测历史,生成当前思考 $h_t$ 和行动 $a_t$;随后通过工具获得观测结果:
\[o_t = T(a_t)\]一个可运行的 ReAct Agent 通常要向 LLM 说明以下内容:
- 角色定义:例如“你是一个能够调用外部工具的智能助手”。
- 工具清单:让模型知道有哪些可用的“手脚”。
- 输出格式:以
Thought/Action等固定结构表达意图,便于程序解析。 - 动态上下文:持续注入用户问题与交互历史,使模型能基于完整上下文决策。
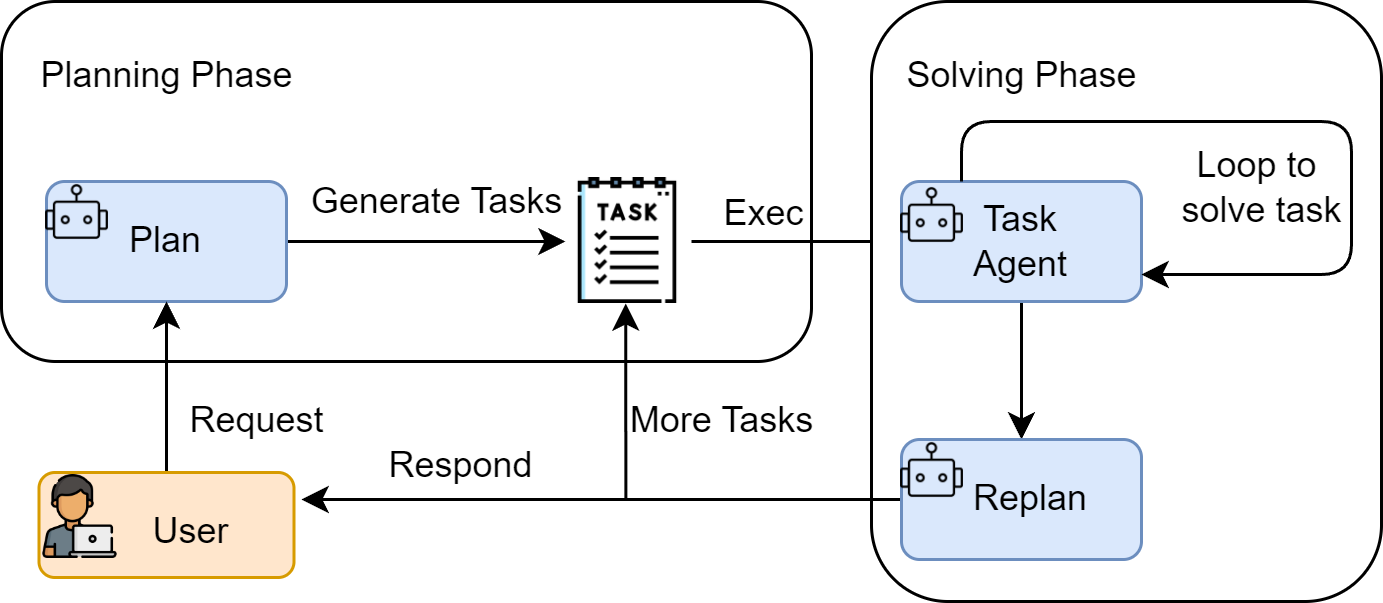
Plan-and-Solve:先规划,再执行
Plan-and-Solve 的核心动机,是避免思维链在多步骤复杂任务中逐渐偏离目标。
- 规划阶段:模型先理解完整问题,将任务拆解为清晰的行动计划。
- 执行阶段:模型按计划逐步完成任务;每一步可以是一次 LLM 调用,也可以是对上一步结果的加工。
形式化地说,规划模型根据原始问题 $q$ 生成一个包含 $n$ 步的计划 $P=(p_1,p_2,\dots,p_n)$:
\[P = \pi_{\text{plan}}(q)\]在执行阶段,$\pi_{\text{solve}}$ 结合原始问题、完整计划和此前的执行结果,依次得到各步解答 $s_i$,最终答案为 $s_n$。
Reflection:执行—反思—优化
Reflection 让 Agent 在得到初稿后主动审视和改进结果。
- 执行:通过 ReAct 或 Plan-and-Solve 产出初步方案,即“初稿”。
- 反思:由独立的模型实例或专用提示词,从多个维度评估初稿并生成结构化反馈。
- 优化:将原任务、初稿和反馈共同作为上下文,生成修订稿。
若 $O_i$ 表示第 $i$ 次迭代的输出,反馈和优化过程可写作:
\[F_i = \pi_{\text{reflect}}(\text{Task}, O_i)\] \[O_{i+1} = \pi_{\text{refine}}(\text{Task}, O_i, F_i)\]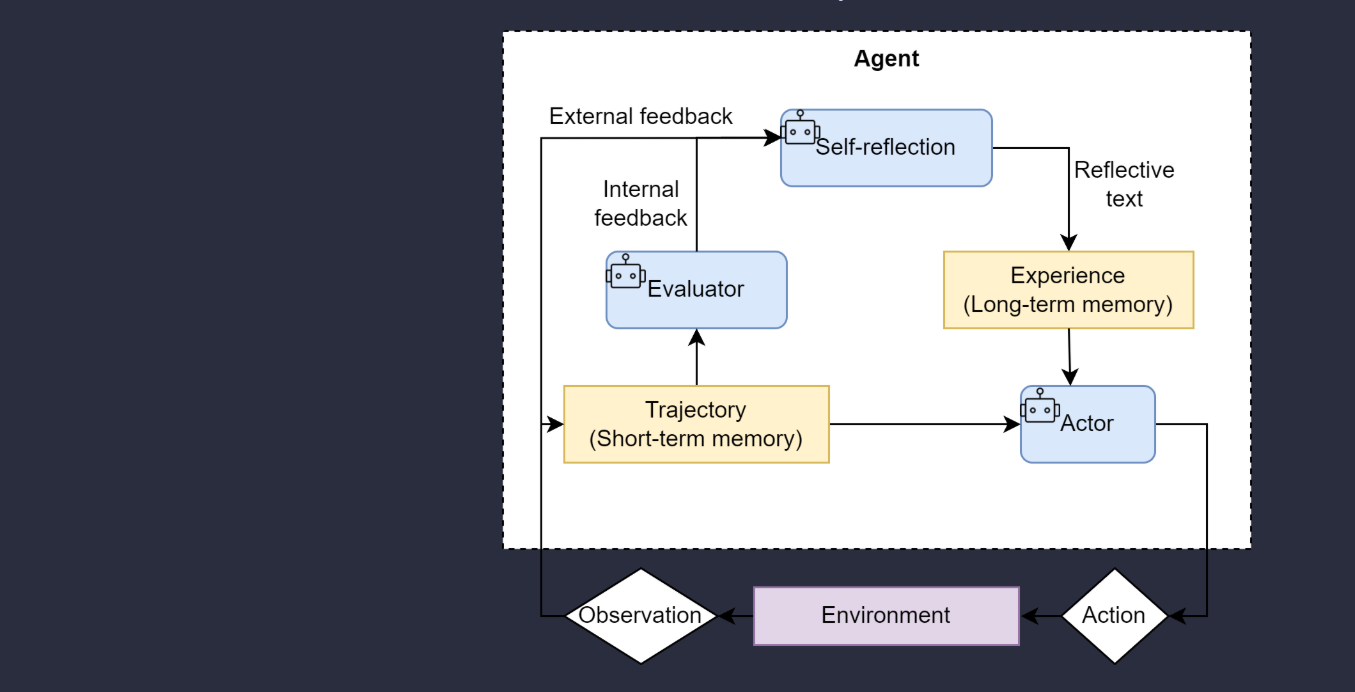
其中,Trajectory 是任务从开始到当前时刻的完整行动轨迹;Evaluator 负责评估轨迹而非直接执行任务;Self-reflection 则将错误原因和规避方式沉淀为可复用的 Experience。
Reflection 是典型的“以成本换质量”策略:每一轮至少会多出反思和优化两次调用,而且串行迭代会显著提高延迟。相应地,它通常能提高最终结果的质量、鲁棒性和可靠性。因此,它更适合对准确性要求很高、但对实时性要求相对宽松的任务。
Agent 框架构建
框架的本质,是提供一套经过验证的规范:将主循环、状态管理、工具调用、日志记录等共性工作抽象封装,让开发者把注意力放在具体业务逻辑上。
它的价值主要在于:
- 提升代码复用和开发效率。
- 解耦核心组件,便于后续扩展。
- 标准化复杂状态管理,包括上下文窗口、历史持久化与多轮对话状态。
- 通过回调等机制简化可观测性和调试。
四种 Agent 框架对比
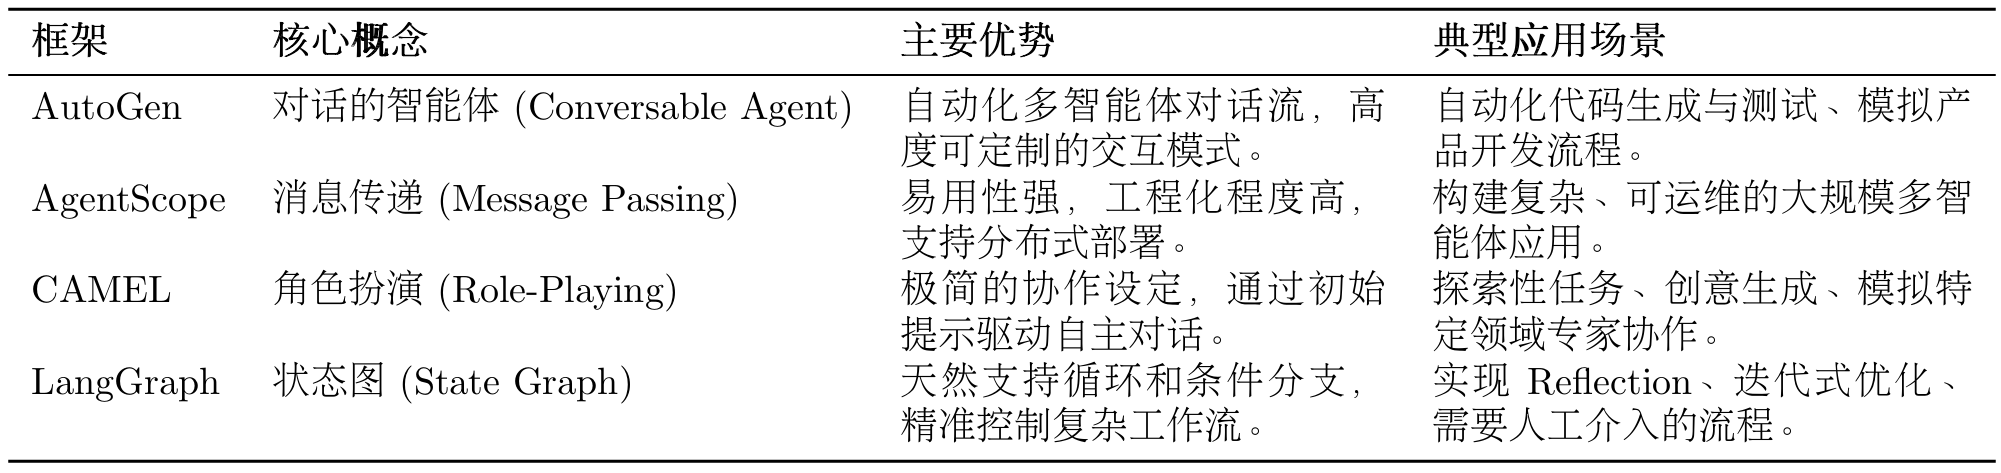
以 LangGraph 为例:它将执行流程建模为图。调用 LLM、执行工具等操作是图的节点,节点间的跳转规则则是边。相较于单向链式结构,这种设计天然支持循环,因此尤其适合 Reflection 一类需要迭代修正的工作流。
一个常见的上下文读取问题
下面的查询理解节点直接取最后一条消息:
def understand_query_node(state: SearchState) -> dict:
    """理解用户查询并生成搜索关键词。"""
    user_message = state["messages"][-1].content
    # ...
问题在于它没有判断消息来源:最后一条消息可能是 AIMessage,而不是用户输入;并且它只读一轮用户消息,无法正确处理上下文依赖。
至少应先倒序查找最近一条 HumanMessage:
user_message = ""
for msg in reversed(state["messages"]):
    if isinstance(msg, HumanMessage):
        user_message = msg.content
        break
在此基础上,还应按任务需要选择相关的历史消息,而不是默认只取最后一句用户输入。
自建框架的目录结构
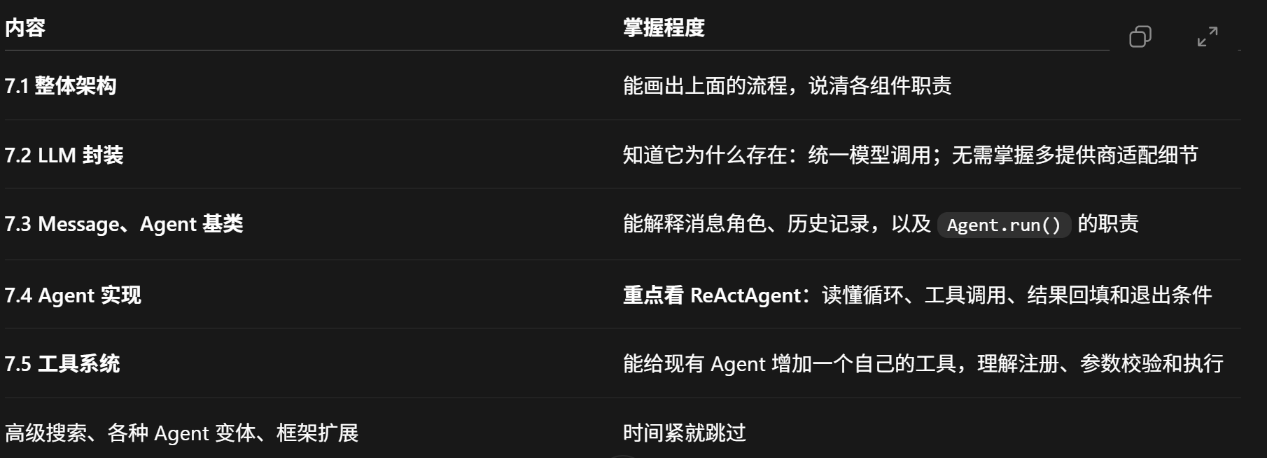
我目前的最小框架结构如下:
hello-agents/
├── hello_agents/
│   ├── core/                     # 核心框架层
│   │   ├── agent.py              # Agent 基类
│   │   ├── llm.py                # HelloAgentsLLM 统一接口
│   │   ├── message.py            # 消息系统
│   │   ├── config.py             # 配置管理
│   │   └── exceptions.py         # 异常体系
│   ├── agents/                   # Agent 实现层
│   │   ├── simple_agent.py
│   │   ├── react_agent.py
│   │   ├── reflection_agent.py
│   │   └── plan_solve_agent.py
│   └── tools/                    # 工具系统层
│       ├── base.py               # 工具基类
│       ├── registry.py           # 工具注册机制
│       ├── chain.py              # 工具链管理
│       ├── async_executor.py     # 异步工具执行器
│       └── builtin/              # 内置工具集
│           ├── calculator.py
│           └── search.py
最小的工作链
用户问题 → Message 组织上下文 → LLM 决定回答或调用工具 → ToolRegistry 找到并执行工具 → 结果放回 Message → LLM 继续判断 → 得到最终答案或达到停止条件。
Message:统一消息格式
Message 类会定义消息角色的类型,用 MessageRole = Literal["user", "assistant", "system", "tool"] 限制其取值,并使用 to_dict() 将对象转换为与 OpenAI API 兼容的字典格式。
def to_dict(self) -> Dict[str, Any]:
    """转换为字典格式(OpenAI API 格式)。"""
    return {"role": self.role, "content": self.content}
Agent:统一启动方式
Agent 类是整个框架的顶层抽象。它定义智能体应该具备的通用行为和属性,具体执行方式由子类实现。通过 Python 的 abc(Abstract Base Classes)模块,可以要求具体智能体实现必要的方法。
@abstractmethod 规定子类必须提供 run(),因此不同类型的 Agent 可以用相同的方式启动,而各子类内部的执行逻辑可以不同。
@abstractmethod
def run(self, input_text: str, **kwargs) -> str:
    """运行 Agent。"""
    pass
工具调用
完整的工具调用流程是:LLM 理解用户问题、选择工具并生成参数 → 工具执行计算并返回结果 → LLM 处理结果并构建最终回答。
下面的例子演示计算器注册与执行,以及如何将计算结果交给模型组织回答:
# 创建包含计算器的注册表
registry = create_calculator_registry()
print("🤖 与 SimpleAgent 集成测试:")

user_question = "请帮我计算 sqrt(16) + 2 * 3"
print(f"用户问题: {user_question}")

# 此处直接指定工具和参数,演示注册表的执行过程
calc_result = registry.execute_tool("my_calculator", "sqrt(16) + 2 * 3")
print(f"计算结果: {calc_result}")

final_messages = [
    {
        "role": "user",
        "content": (
            f"计算结果是 {calc_result},请用自然语言回答用户的问题:"
            f"{user_question}"
        ),
    }
]
需要注意,这个例子中作者直接提取了计算表达式,并指定使用 my_calculator 工具;工具选择和参数生成还没有交给 LLM。final_messages 只是构建了消息,后续还需要发送给模型才能得到最终回答。
一起聊聊
欢迎留下想法。评论由 GitHub Issues 托管,登录 GitHub 后即可参与。
评论框没有显示?直接在 GitHub 留言 ↗